WARNING
本文档由 AI 自动翻译,仅供参考。涉及关键操作或信息时,请以英文原文为准。
在 Open WebUI 中与文档和知识库聊天
Open WebUI 支持检索增强生成(RAG),可帮助本地 AI 模型基于你上传的文档或整理好的知识库回答问题。
本指南介绍如何在聊天会话中分析单个文档,以及如何构建可重复使用的持久知识集合。
学习目标
在本指南中,你将学习如何:
- 配置嵌入模型来处理文档文本。
- 在聊天会话中上传并分析单个文档。
- 构建和管理持久知识库。
- (可选)为复杂文档版式配置高级内容提取引擎。
前提条件
开始前,确保已满足以下条件:
已安装并配置 Open WebUI,且至少连接了一个本地模型。
拥有 Open WebUI 实例的管理员权限。
以下模型:
模型类型 模型 获取方式 Embedding EmbeddingGemma 从应用市场安装
配置嵌入模型
文档理解需要嵌入模型将文本转换为向量数据。要配置 Open WebUI,需要先获取嵌入模型信息。
获取嵌入模型信息
从启动台打开嵌入模型应用。其模型控制台会自动打开。
等待模型显示就绪,且引擎显示运行中。
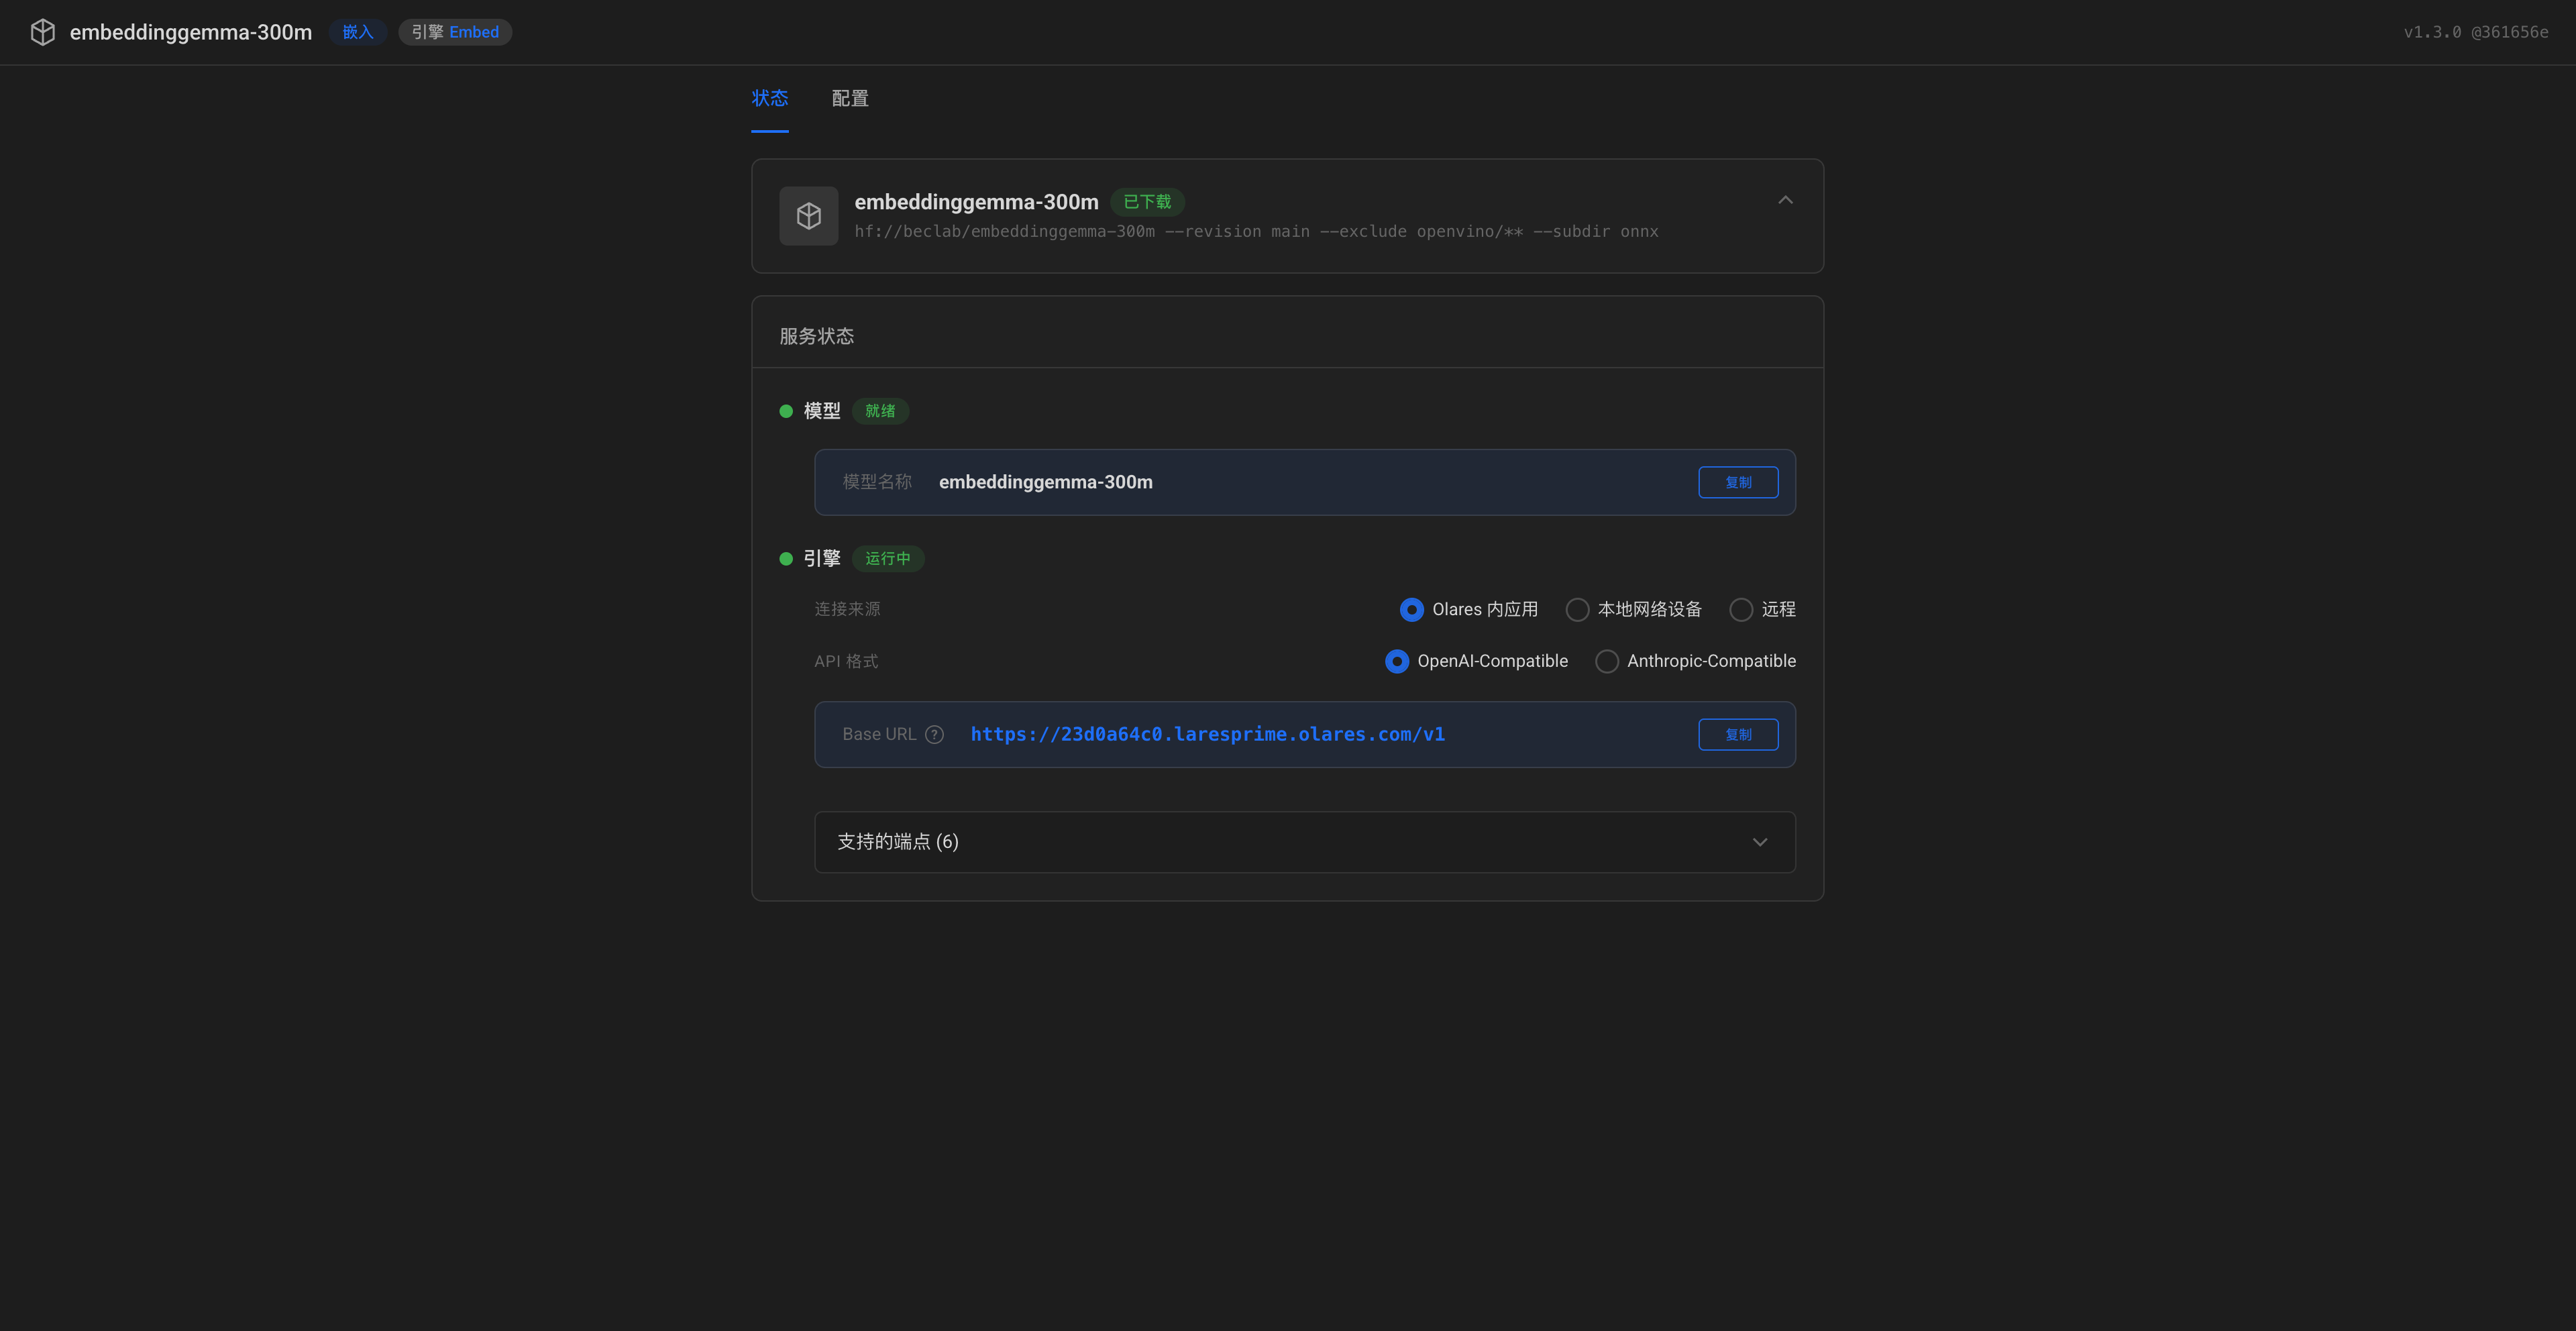
在模型部分,按显示内容原样复制模型名称。
在引擎部分:
a. 连接来源:选择 Olares 内应用。
b. API 格式:选择 OpenAI-Compatible。
c. 按显示内容原样复制 Base URL 地址。
在 Open WebUI 中应用嵌入设置
在 Open WebUI 中,选择你的头像图标,然后前往 Admin Panel > Settings。
在左侧边栏中,找到 Tools 部分,然后选择 Documents。
在 Embedding 区域中,指定以下设置:
- Embedding Model Engine:选择 OpenAI。
- API Base URL:输入你从 Model Console 复制的嵌入模型的 Base URL。
- Embedding Model:输入你从 Model Console 复制的嵌入模型的 Model name。
向下滚动到页面底部,然后点击右下角的 Reindex 以应用更改。
选择 Save。
分析单个文档
将文档直接附加到聊天会话中,用于一次性的分析和总结。
开始一个新聊天。
选择模型。
点击聊天输入框下方的 add_2,然后选择 Upload Files。
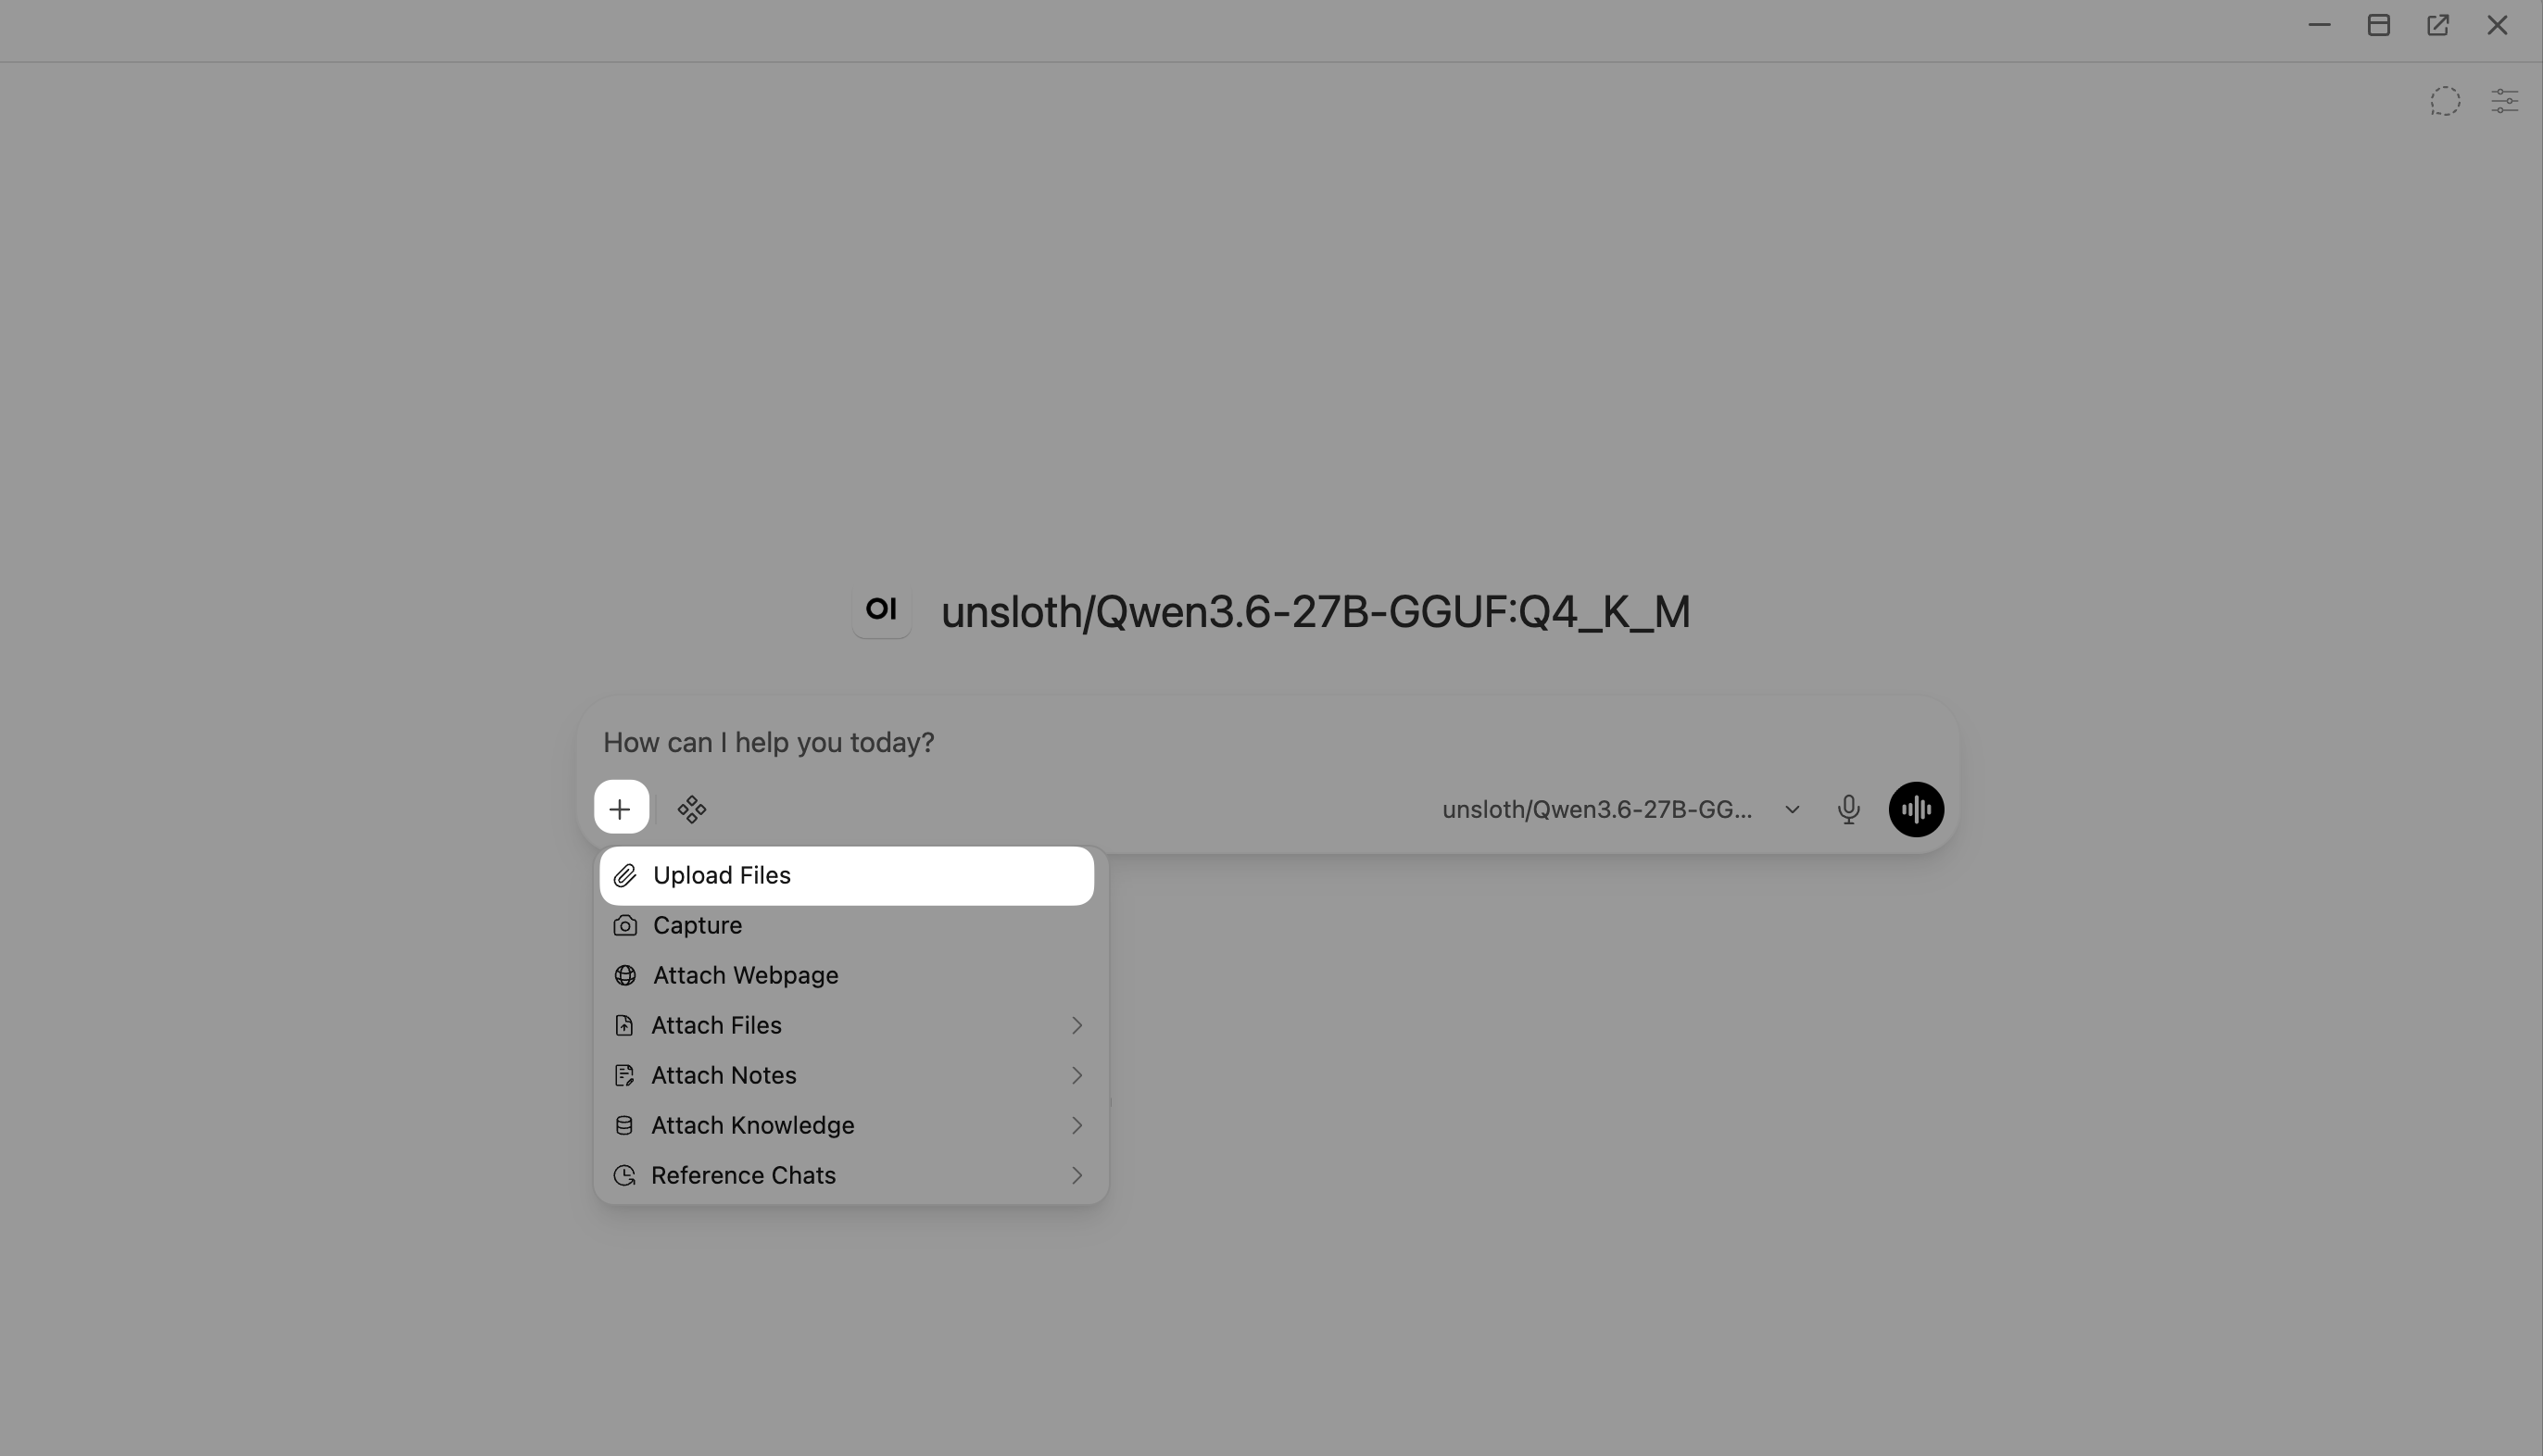
上传 PDF 或文本文件。
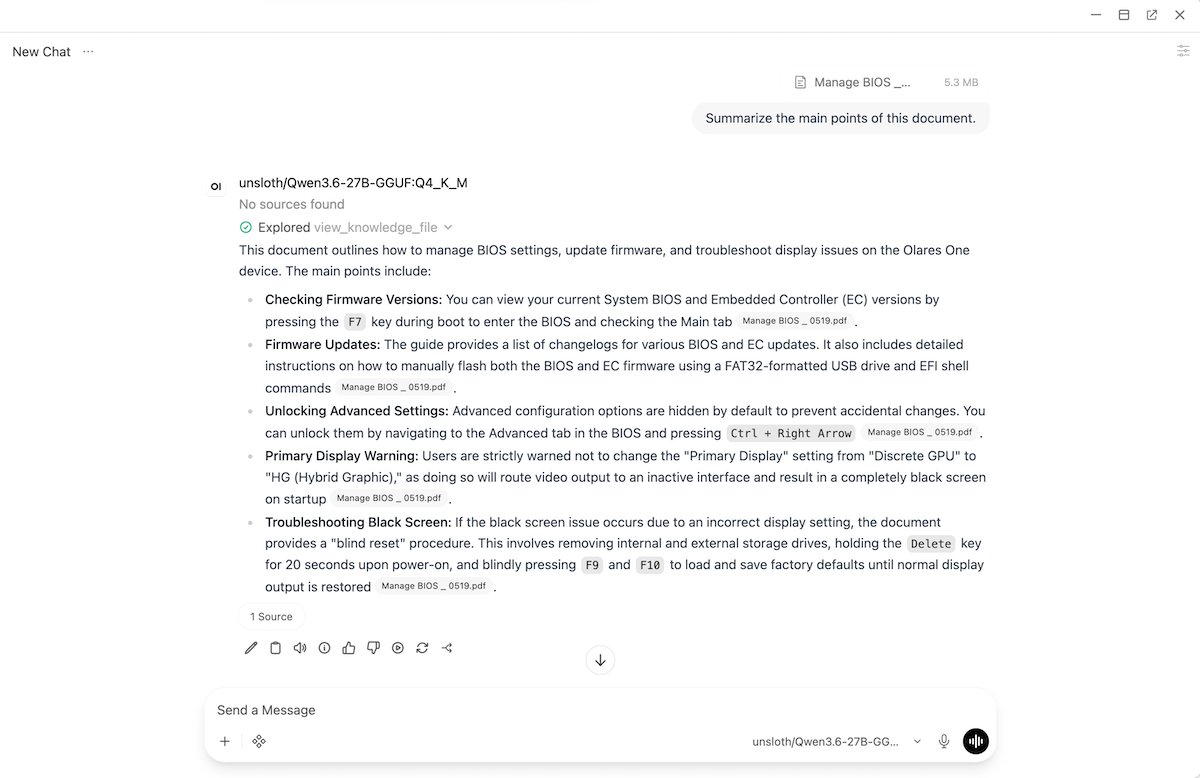
输入提示词,让模型分析文档。例如:
plainSummarize the main points of this document.提交提示词。如果生成的回复包含文件引用,说明 Open WebUI 已成功将该文档加入上下文。
构建知识库
对于需要在多个聊天中重复使用的文档,需创建持久知识库。
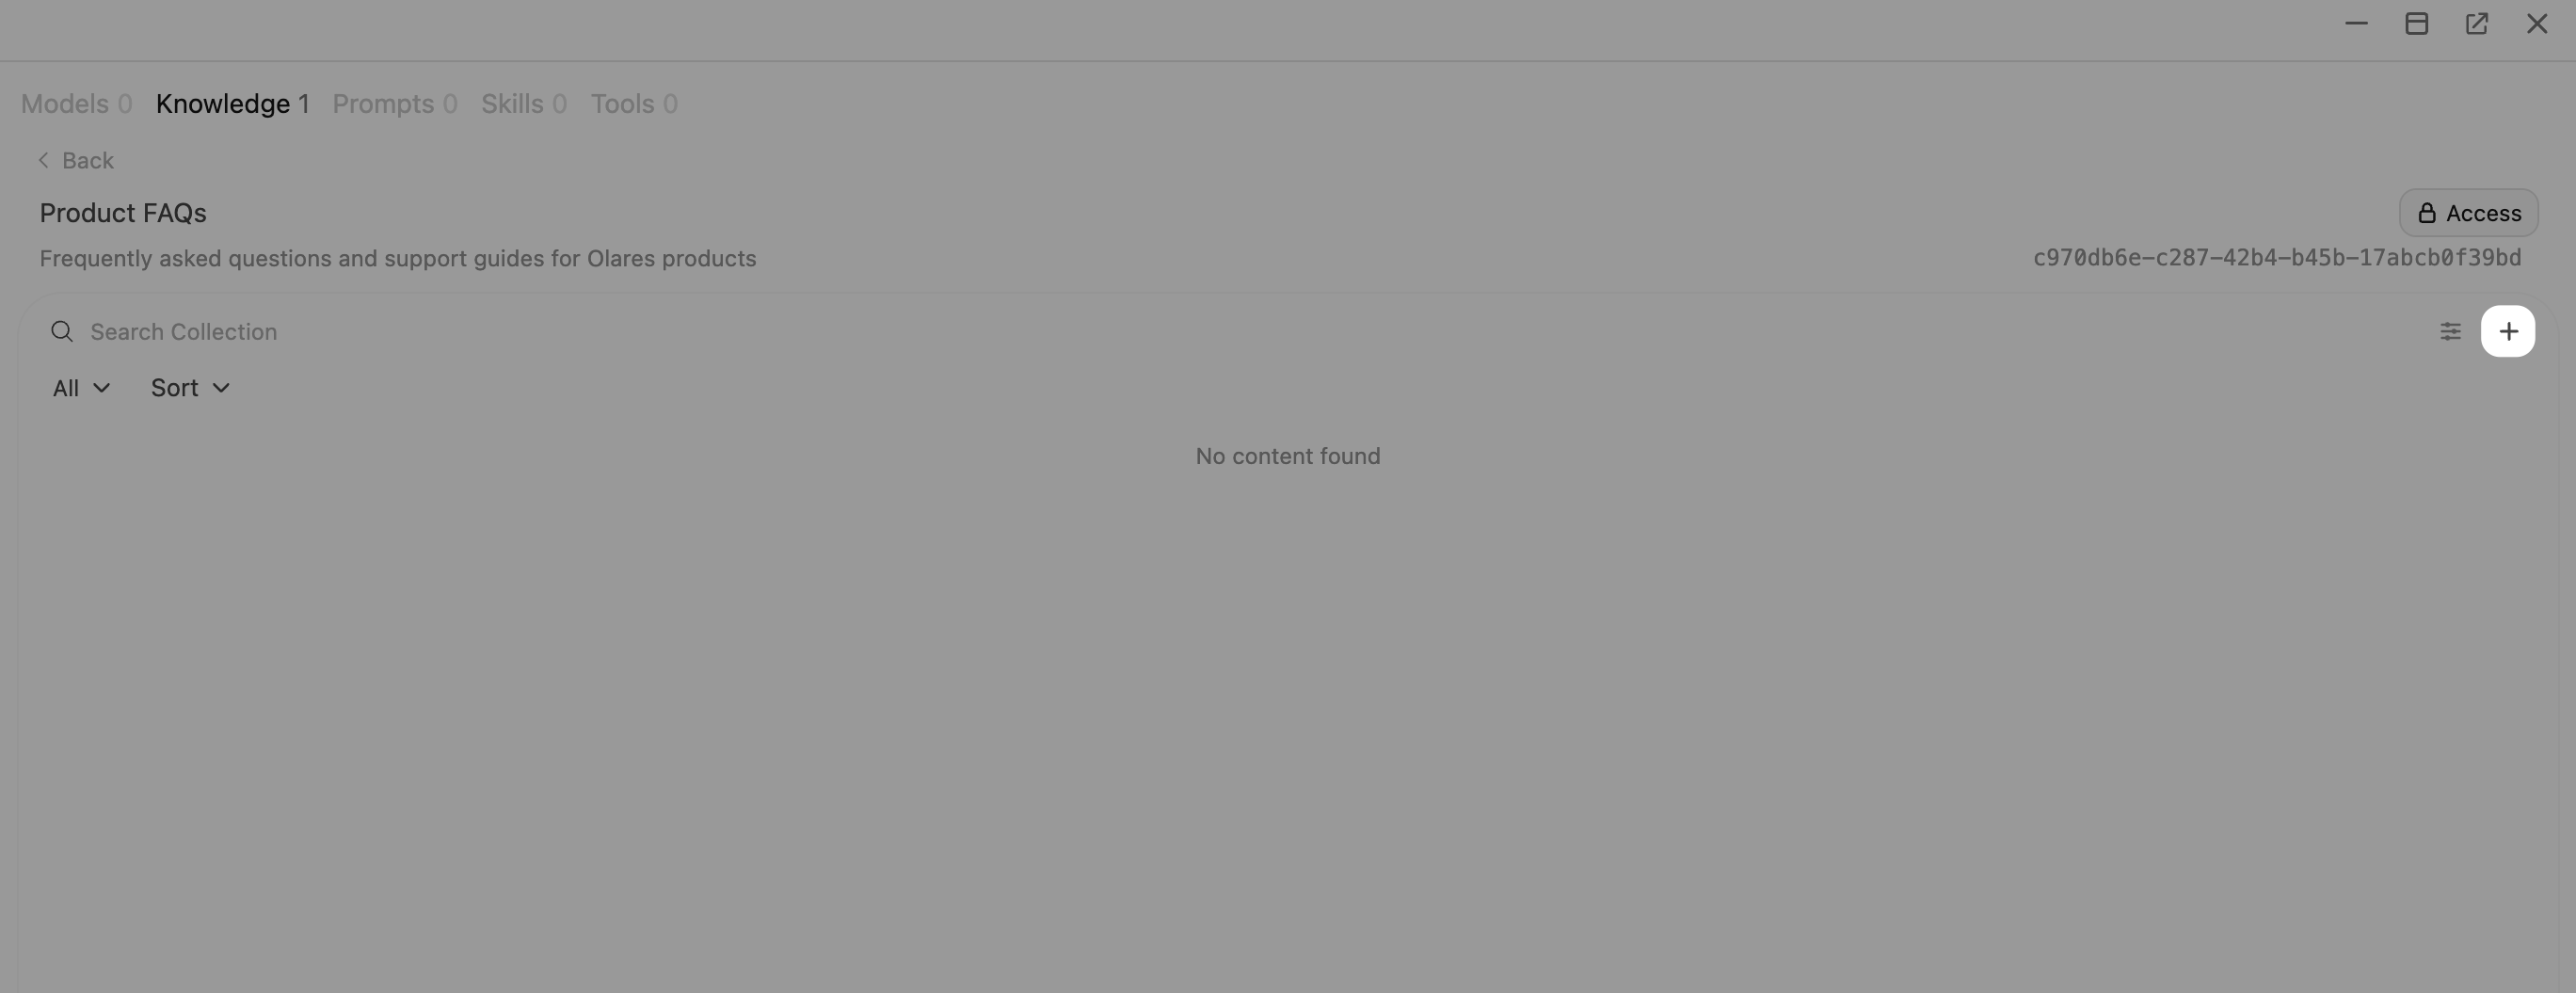
在 Open WebUI 中,点击你的头像图标,然后前往 Workspace > Knowledge。
点击 Create。
在 What are you working on 字段中,输入知识库名称。例如:
Product FAQs。在 What are you trying to achieve 字段中,输入描述。例如:
Frequently asked questions and support guides for Olares products。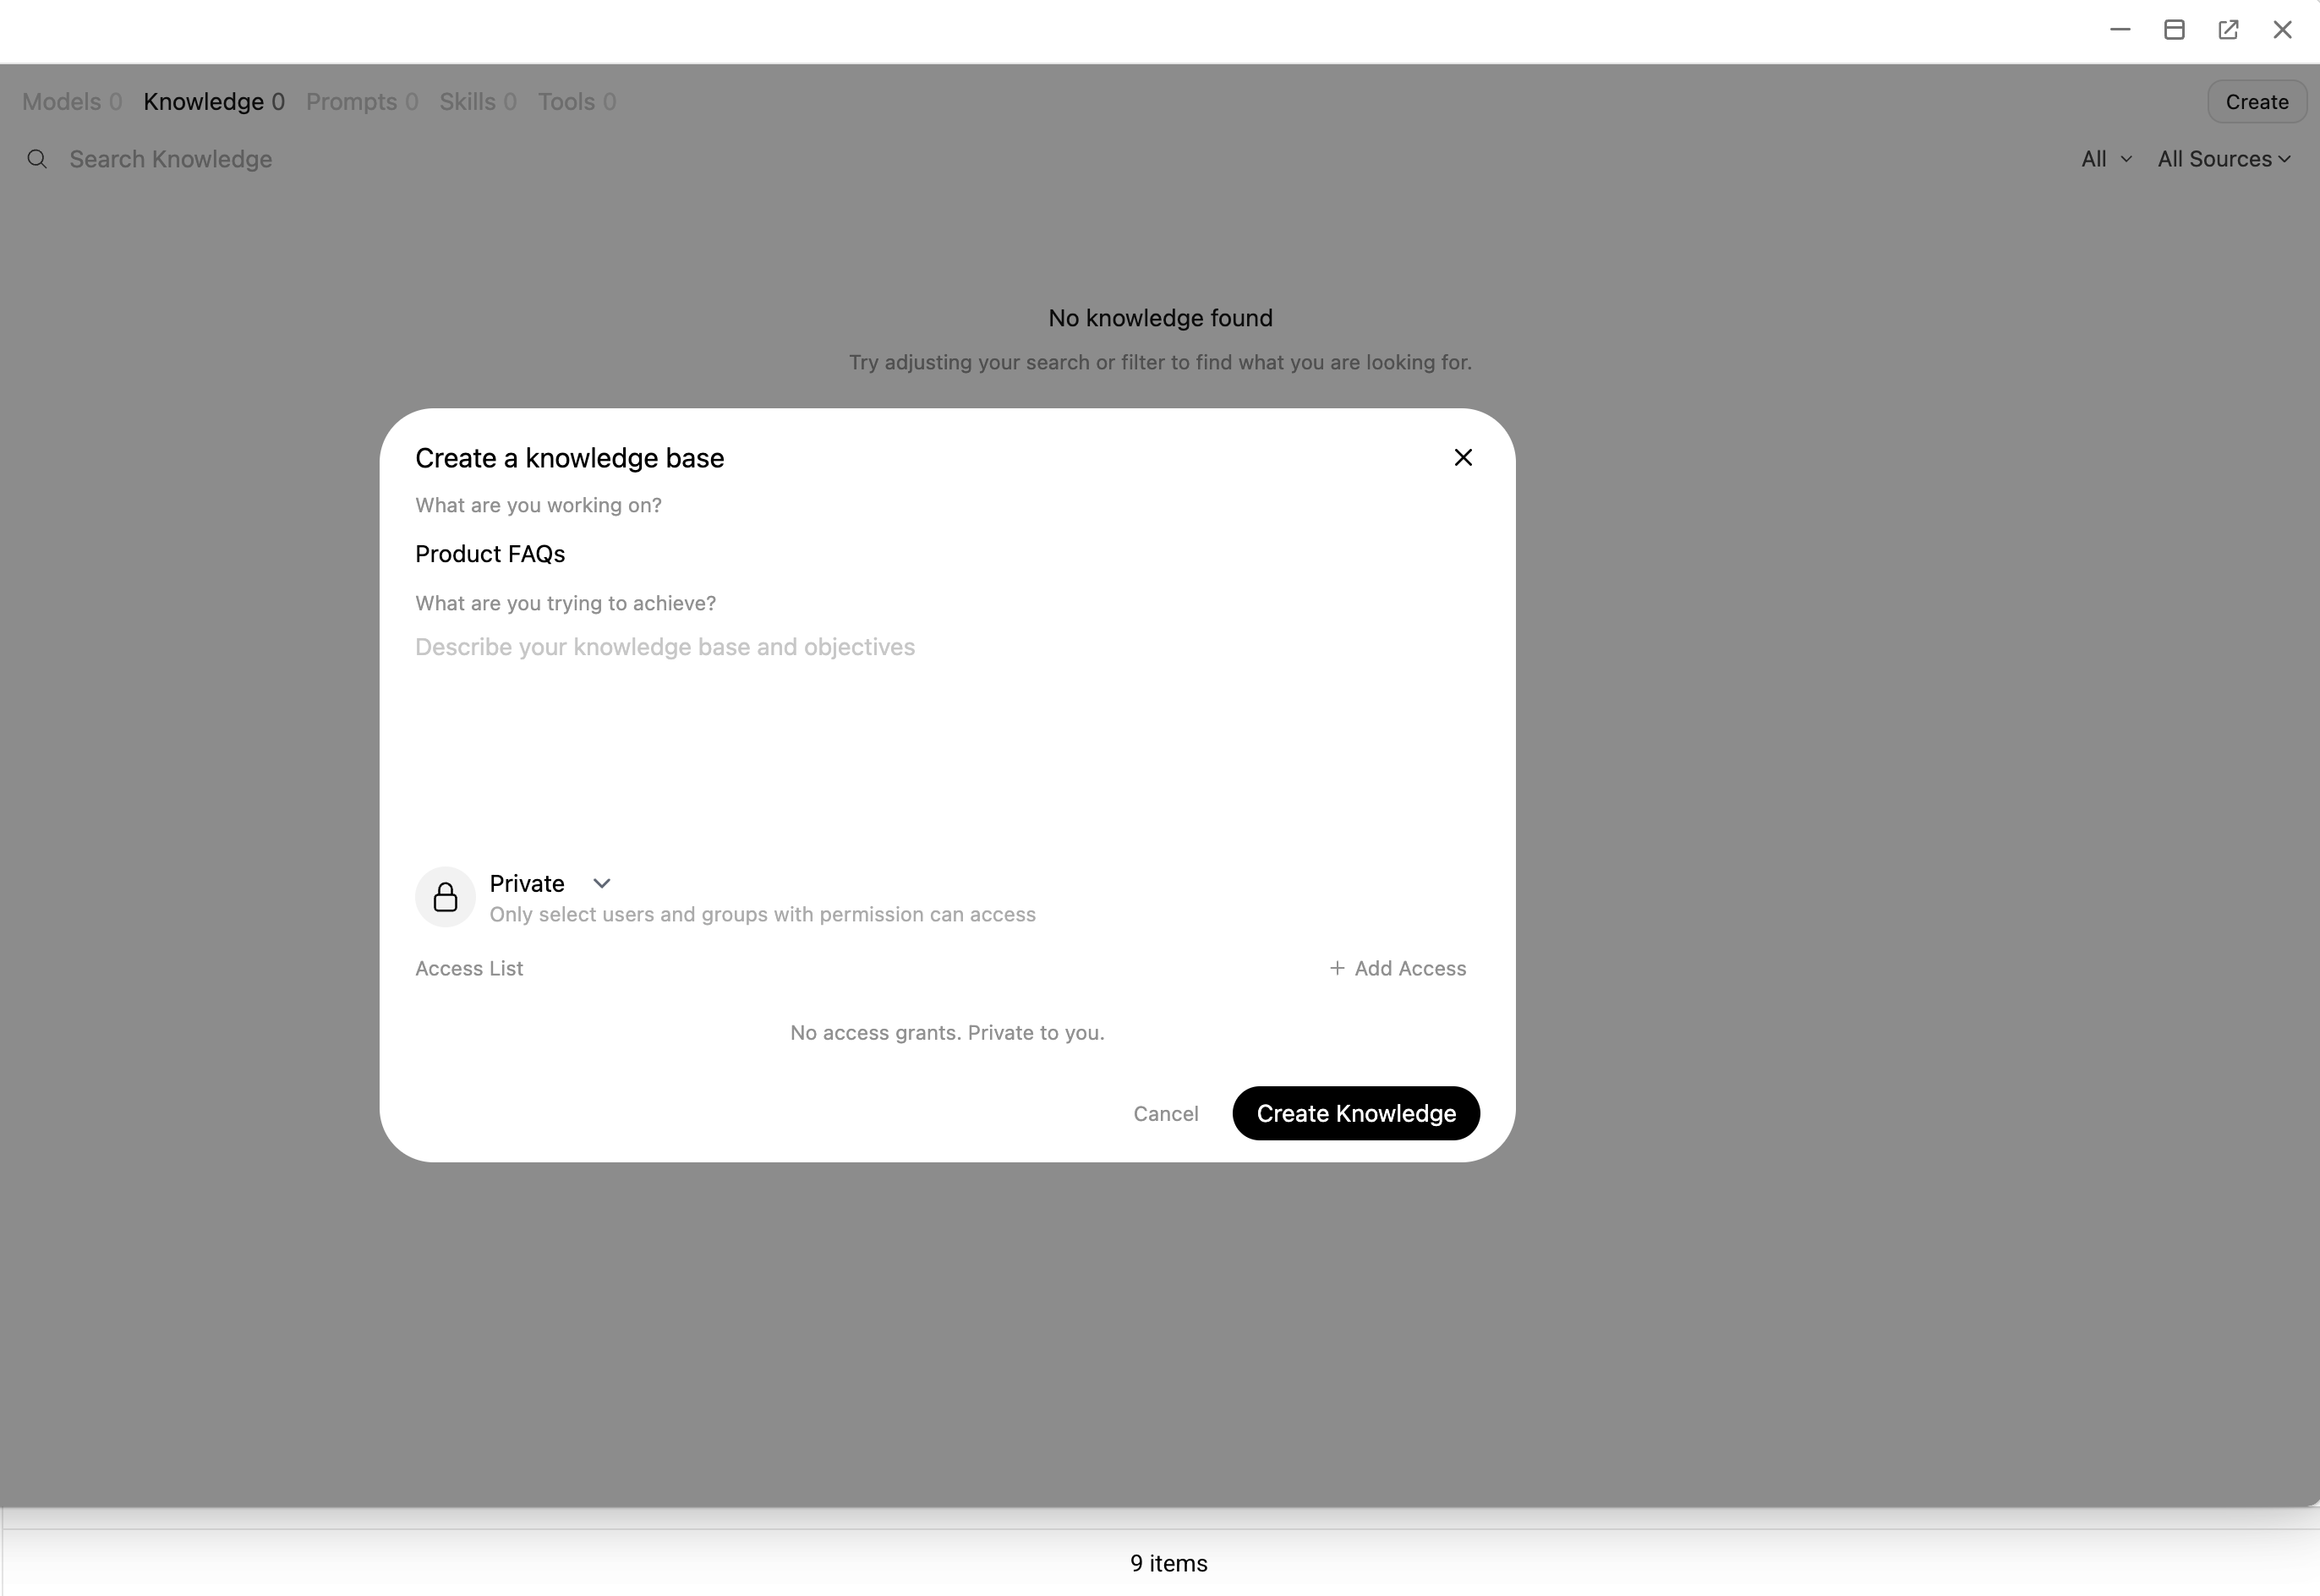
点击 Create Knowledge 保存集合。
点击 add > Upload files,然后上传文件来填充知识库。
将知识库附加到聊天
创建知识库后,将其附加到聊天中,以便模型可以引用其内容。
开始一个新聊天。
选择模型。
点击聊天输入框下方的 add_2,然后选择 Attach Knowledge。
选择要使用的知识集合。
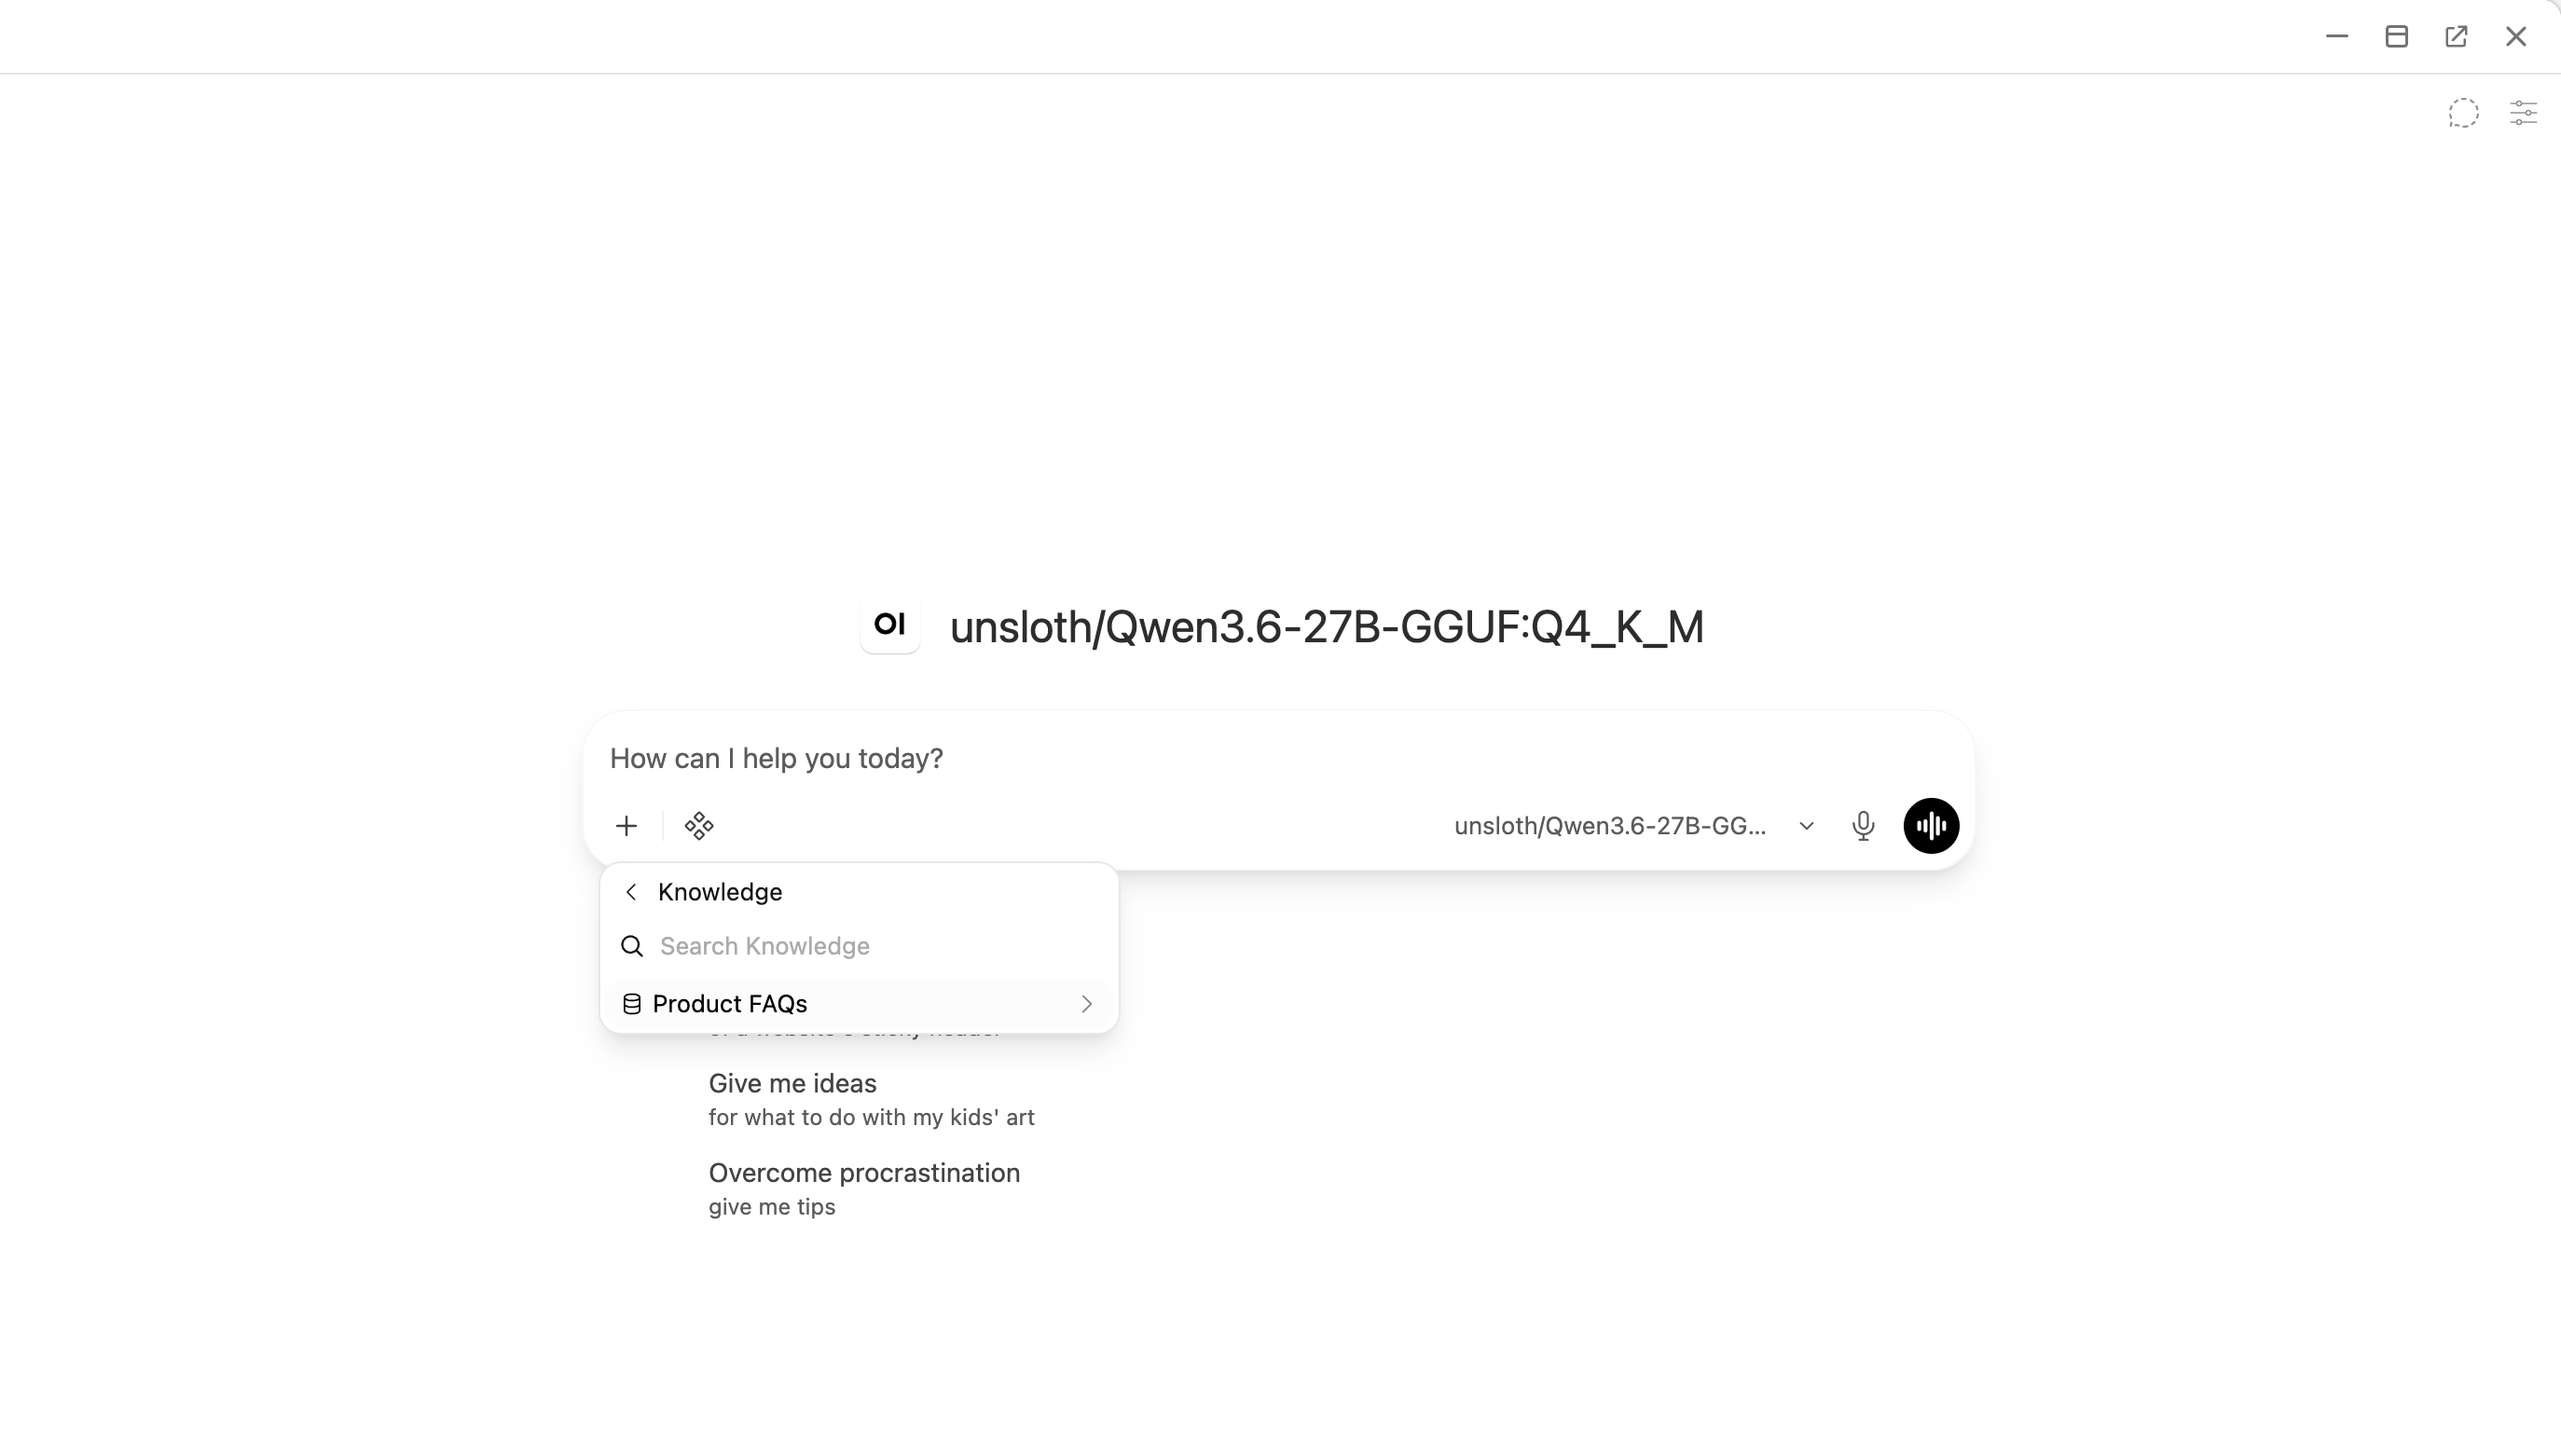
询问与知识库内容相关的问题。模型会检索相关段落,并在回复中引用它们。
(可选)配置高级提取引擎
默认情况下,Open WebUI 使用简单的文本提取引擎。对于包含表格或复杂格式的文档版式,需切换到 PaddleOCR,以获得更好的准确性。
性能影响
PaddleOCR 需要更多 GPU VRAM,处理文档也比默认引擎更慢。仅在文档版式质量非常关键时使用该引擎。
从应用市场安装 PaddleOCR 应用。
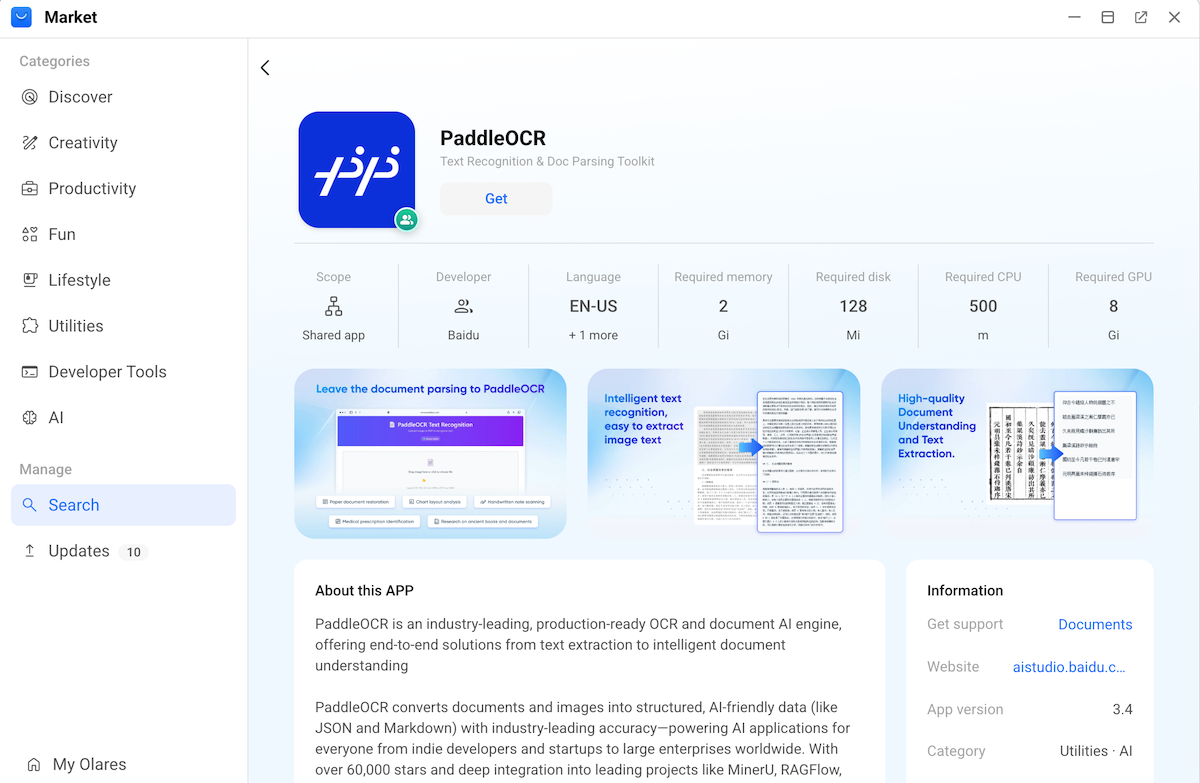
获取 PaddleOCR 端点 URL:
a. 打开 Olares 设置,然后前往应用 > PaddleOCR > 入口。
b. 点击 PaddleOCR,然后复制端点 URL。例如:
https://17b4c78a.laresprime.olares.com。在 Open WebUI 中,前往 Admin Panel > Settings。
在左侧边栏中,找到 Tools 部分,然后选择 Documents。
在 Content Extraction 区域中,按如下方式配置:
a. Content Extraction Engine:在下拉列表中选择 PaddleOCR-vl。
b. API Base URL:输入 PaddleOCR 端点 URL。
c. API Token:输入任意文本,例如
local。不要留空。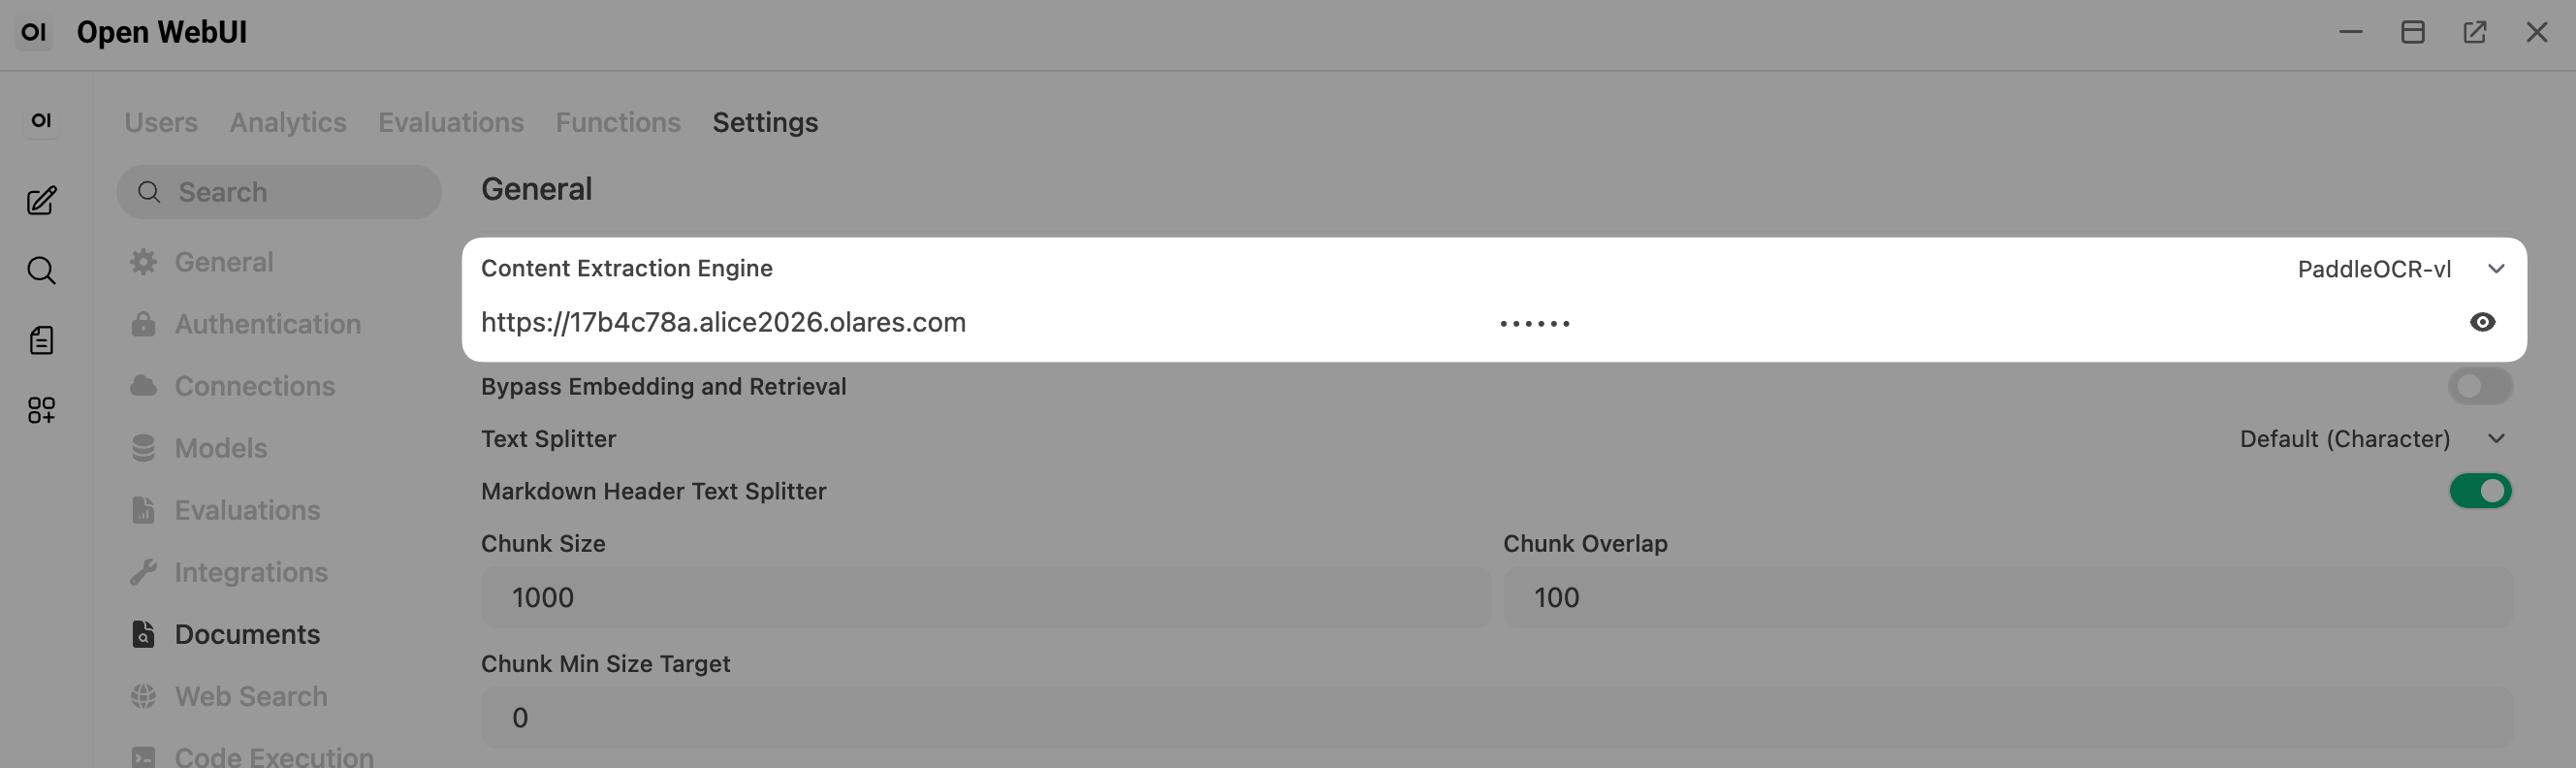
点击 Save。